Raptor Series
Gen AI プロセッサ
製品とサービス

Viper シリーズ LLM 推論カード
Neuchips Viperシリーズは、Raptor N3000 Gen AIプロセッサ、高度なデータ圧縮技術、および64GBのオンボードメモリを備えたエンタープライズ向けオフラインAIソリューションです。ローカル処理によってデータを外部に出さず、セキュアかつ高効率なRAG(Retrieval-Augmented Generation)アプリケーションに特化し、完全なデータプライバシーを維持します。
概要
| Neuchips 製品 | Viper Series Gen AI PCIe カード | |||||
|---|---|---|---|---|---|---|
| オフライン AI ソリューション | | | | | | |
| ドメイン特化型 AI アプリケーション |
|
|
|
|
|
|
| システムインテグレーター | HW/SWシステムインテグレーションサービス|ドメイン特化API管理 | |||||
| ソフトウェアサービス プロバイダー/ アプリケーションインターフェース | デバイス管理プラットフォーム|ファインチューニング|ドキュメント連携|RAG など | |||||
| オープンソース AI モデル (単体カードで最大140億パラメータに対応) | 生成AI/LLMモデル(Llama | Mistral | Gemma | Phi | TAIDE | Qwen | DeepSeek Distilled ... ) | |||||
| システムハードウェアメーカー | PC|IPC|ワークステーション|サーバー | |||||
使いやすいSDK
| ユーザーアプリケーション | ||
| ソフトウェア開発キット(SDK) | ||
| コンパイラ | Neuchips PyTorch Extension | |
| FFP8 量子化 | ||
| オペレータ最適化 | ||
| グラフ分割 | ||
| グラフ最適化 | ||
| メモリ計画 | ||
| 共有カーネル | カスタムカーネル | |
| ランタイム | ||
| Neuchips Raptor Series | ||
|---|---|---|
エンタープライズAIを
安全かつシームレスに変革
安全かつシームレスに変革
Viper GenAI PCIeカードは、強力なハードウェアアクセラレーションと実務的なビジネス機能を組み合わせた、エンタープライズ向けAIソリューションのブレイクスルーです。中核となるRaptor Gen AIプロセッサは、専用のエンベディングエンジンを備え、最大10倍の効率向上を実現します。32GBのオンボードメモリは専用ベクターデータベースとして機能し、CPU負荷を大幅に軽減しながら、ローカル環境での安全なデータ処理を可能にします。複数のオープンソースLLMモデルをサポートし、既存インフラとのシームレスな統合を提供することで、Viperはデータセキュリティを損なうことなくAI機能を実装することを可能にします。これにより、機密データや業務プロセスを完全に自社管理しながらAI技術を活用したい企業にとって、非常に価値の高いソリューションとなっています。
仕様
| Viper Series 仕様 | |
|---|---|
| 項目 | 内容 |
| 対応 LLM モデル | Llama | Mistral | Gemma |Phi | TAIDE | Qwen | DeepSeek Distilled ... |
| ボード全体消費電力 | 最小 = 25W デフォルト = 45W 最大 = 75W |
| 冷却ソリューション | アクティブ/パッシブ冷却に対応 |
| メカニカルフォームファクター | HHHL-SS (ハーフハイト・ハーフレングス・シングルスロット) |
| メモリタイプ | LPDDR5 |
| メモリ容量 | 最大 64GB |
| メモリクロック | 6400 Mbps |
| 動作周囲温度 | 0°C ~ 50°C |
| 保管温度 | -40 °C ~ 75°C |
| 動作湿度 | 相対湿度 5% ~ 85% |
| 保管湿度 | 相対湿度 5% ~ 95% |
主な特長
組み込みベクタ処理エンジン
- 高効率なエンベディングエンジンを内蔵
- カードとホストCPU間の通信オーバーヘッドを削減
- ベクトル類似検索の効率を10倍向上
- 64GBのLPDDR5メモリを搭載し、1チップ/1カード構成で最大140億パラメータのLLMモデルに対応
32GBオンデバイス・ベクタストレージ
- オンプレミス型ベクターデータベースとして機能
- 冷却要件を軽減
- ボード上に大容量のベクトルデータを直接格納可能
- 革新的な量子化技術により、ベクトルデータを4分の1に圧縮
LLMモデル対応
- 事前学習済みLLMモデルと互換
- Llama, Mistral, Gemma, Phi, TAIDE, Qwen, DeepSeek Distilled などをサポート
- 英語や繁体字中国語など、複数言語で動作
低消費電力設計
- ボード全体の平均消費電力はわずか45W
- 動作温度範囲は0°C〜50°C
- パッシブ/アクティブ両方の冷却ソリューションに対応
主なメリット
コスト削減を最大化し、AIコストを最小限に
AI運用をすばやく効率的に変革
高効率でコンパクト、ハードウェアの煩雑さゼロ
業務をスリム化し、アウトプットを最大化
オフラインセキュリティでデータ漏えいゼロ
低消費電力で高いサステナビリティ
エコシステム・アライアンス
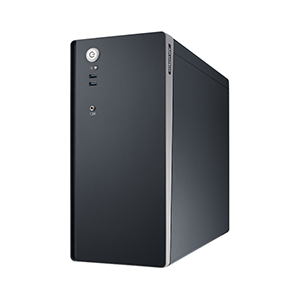
- AIR-510
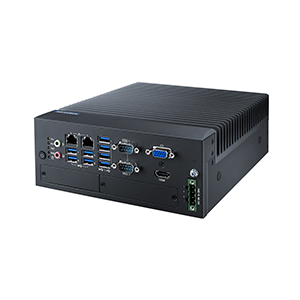
- MIC-770